Колебания мощности при обучении ИИ: почему дата-центрам нужно сглаживать нагрузку
При проектировании дата-центра важно знать, сколько электрической мощности потребуется вычислительному оборудованию и как быстро это потребление будет меняться. Современные профили нагрузки делают этот вопрос особенно существенным: тысячи ускорителей могут одновременно переходить от интенсивных вычислений к режимам с меньшим потреблением и обратно. Происходят повторяющиеся перепады, а при запуске и завершении задачи возникают резкие изменения нагрузки. Такие режимы влияют на выбор силового оборудования, полезную мощность площадки, стоимость и возможность ее расширения.
Почему обучение меняет график потребления
В многоклиентском центре обработки данных (ЦОД) множество информационных систем работает независимо. Их загрузка меняется в течение суток, задания начинаются и заканчиваются в разное время. Когда потребление одних серверов растет, другие могут снижать активность. Отдельные всплески частично усредняются, поэтому суммарная нагрузка обычно меняется плавнее, чем нагрузка отдельного потребителя. [1]
При распределенном обучении трансформеров графические процессоры (GPU) работают в общем пуле. Они выполняют вычисления, рассчитывают градиенты (величины, определяющие изменение параметров модели), затем обмениваются результатами. Во время обмена активность вычислительных блоков может снижаться. Синхронные переходы между фазами складываются в общий перепад мощности кластера. [2]
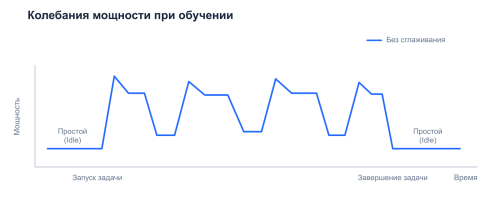
Рисунок 1. Схематический профиль потребления при обучении ИИ.
На графике видны три режима. При запуске потребление быстро возрастает. Во время обучения повторяются подъемы и спады, связанные со сменой активности GPU. После завершения ускорители одновременно возвращаются к низкому потреблению. Электроснабжение должно быть рассчитано не только на оба перехода, но и на кратковременное превышение потребления. [1]
Чем большую долю площадки занимает одна задача, тем сильнее ее рабочий цикл определяет общий график. Это касается и облака: крупные заказчики может одновременно запустить множество заданий рендера, инференса, обучения или перебора. Совпадение стартов создает общий скачок, даже если сами задания независимы. Распределенное обучение добавляет к нему повторяющиеся согласованные переходы внутри задачи. [3]
Агрессивное управление питанием усиливает переходы
GPU использует доступный температурно-тепловой запас, чтобы повышать производительность. При появлении работы быстро меняются активность блоков и частоты. Ограничение потребления и температурное ограничение действуют отдельно: частоты могут снижаться как при достижении лимита мощности, так и при достижении температурного порога. Поэтому наибольший электрический пик при переходе к вычислениям может возникать еще до существенного нагрева устройства. [4]
Для дата-центровых GPU описываются пики потребления в 50 мс при удержании средней мощности в пределах тепловой расчетной мощности (Thermal Design Power, TDP) на интервале в секунду. Их прохождение за пределы стойки зависит от конструкции питания. [2]
Разница между средним и максимальным потреблением видна и на конкретной видеокарте. У MSI GeForce RTX 5090 SUPRIM в Cyberpunk 2077 при разрешении 2160p, режиме Overdrive и DLAA средняя мощность составила 605,8 Вт, максимальная достигла 684,6 Вт. Измерение учитывало пики длительностью более 5 мс. Это профиль конкретной платы в игровой нагрузке; для серверного кластера нужны измерения на его собственных задачах. На наших собственных тестах 5090 увеличивало мгновенное потребление до 700 Вт, при настройке максимального TDP в 575 Вт. [5]
В отдельных случаях, при интенсивной смене задач, такие пики могут быть достаточно частыми и особенно проявляют себя на GPU новых архитектур: NVIDIA Blackwell и Vera Rubin.
Что это меняет в инженерном проекте ЦОД
Колебания нагрузки воздействуют на всю цепочку электроснабжения: блоки питания серверов или стоек, распределительные устройства, источники бесперебойного питания (ИБП), трансформаторы и внешний ввод. Номинальная мощность оборудования характеризует длительный режим, а способность выдерживать кратковременные переходы требует отдельной проверки. [6]
Особенно важна динамика при работе от дизель-генератора. После резкого увеличения нагрузки двигатель должен нарастить механическую мощность; до восстановления баланса возможны снижение частоты и просадка напряжения. Серверные источники питания в своем рабочем диапазоне сохраняют выходную мощность, увеличивая входной ток при падении напряжения. Поэтому прием нагрузки зависит и от ее величины, и от скорости подключения. [7]
Повторяющиеся колебания создают дополнительную задачу: их частоты могут возбуждать колебательные режимы энергосистемы. Для крупной площадки требуется согласовать с поставщиком электроэнергии допустимый характер изменения потребления. Увеличение номинальной мощности подключения само по себе такую задачу не решает. [1]
Если пики доходят до внешних участков питания, под них приходится предусматривать дополнительную мощность силового оборудования. Такой запас оплачивается целиком, хотя используется кратковременно. При ограниченном вводе он также занимает часть бюджета мощности, который мог бы обслуживать дополнительные стойки. Размер необходимого запаса определяется фактическим профилем нагрузки, характеристиками оборудования и требованиями надежности. Сглаживание дает возможность уменьшить переходные максимумы, по которым выбирается внешняя инфраструктура. [1]
Уровень ПО: заполнять спады вспомогательной работой
Программное сглаживание может поддерживать потребление, когда основная задача временно снижает активность. Система отслеживает работу GPU и запускает вспомогательные вычисления, например асинхронный инференс (батчинг), при появлении свободных ресурсов. Когда обучение снова загружает ускоритель, вспомогательная нагрузка снимается. Так уменьшается глубина провалов мощности. Верхний пик при этом остается прежним. Этот подход реализован в Firefly. [2], [8]
Цена метода связана с дополнительной работой. Искусственная нагрузка расходует энергию без основного результата, занимает память и вычислительные ресурсы. Полезное фоновое задание требует сохранения и восстановления состояния, что усложняет быстрые переключения. Нужна быстрая телеметрия (измерения мощности и активности GPU); запоздалая реакция вспомогательной задачи может мешать обучению. При прямом доступе клиента к GPU такой механизм требует согласования с его программной средой. [2]
Для независимых клиентских заданий практический вывод проще: их старты можно разнести во времени, уменьшив общий скачок запуска. Однако такой прием не устраняет внутренние колебания одной большой синхронной задачи, поэтому распределенному обучению требуется управление непосредственно во время работы.
Уровень GPU: управлять пределами и скоростью изменения мощности
На поддерживаемых ускорителях Blackwell поведение задается профилем power smoothing (сглаживания мощности). Контроллер получает ограничения скорости нарастания и снижения потребления, power floor (минимальный уровень потребления) и задержку перед окончательным сбросом нагрузки. Параметры настраиваются через средства управления GPU, включая NVIDIA SMI и программные интерфейсы. [4]. [9]
При запуске постепенно повышается power cap (верхний предел разрешенной мощности). Кластер выходит на рабочий уровень с заданной скоростью, не превышая ожидаемый TDP. Настройка power limit (лимита мощности) определяет допустимое потребление; для сглаживания перехода контроллер должен также ограничивать скорость его нарастания. [1]
При снижении активности применяется power burn (искусственное поддержание потребления аппаратным механизмом GPU). Ускоритель временно продолжает расходовать энергию, чтобы избежать резкого сброса нагрузки. Если полезная работа возобновляется, этот режим отключается. Если пауза затягивается или задача завершена, потребление плавно уменьшается. Задержка перед снижением позволяет пережить короткую паузу без полного сброса и последующего резкого подъема мощности. [1]
В этой схеме профиль задается программно, а быстрый отклик обеспечивает контроллер и аппаратный механизм ускорителя. Дополнительный процесс с матричными вычислениями для этого не требуется. Энергетический компромисс при этом сохраняется: поддержание высокого минимального потребления увеличивает расход электричества, а чрезмерное ограничение мощности может замедлять полезную работу. [1]
Уровень инфраструктуры: накапливать энергию рядом с нагрузкой
Для коротких повторяющихся колебаний можно использовать накопитель. В периоды сниженного потребления он заряжается, а при росте нагрузки отдает энергию вычислительному оборудованию. Так мощность GPU меняется в соответствии с задачей, а внешняя система питания получает более ровный профиль.
В блоках питания стойки GB300 NVL72 эту функцию выполняют электролитические конденсаторы с контроллером заряда. Они компенсируют быстрые колебания между фазами работы. Энергия перераспределяется во времени; потери преобразования и хранения сохраняются, но для заполнения каждого спада не требуется искусственно загружать GPU. [1]
При выборе накопителя важны два параметра: мощность, которую он способен принять или отдать, и запас энергии, определяющий длительность компенсации. Небольшой быстрый буфер может обслуживать короткие импульсы, но для продолжительного отклонения требуется больший запас. Поэтому накопление энергии сочетают с управлением запуском и завершением задачи: это позволяет распределить разные переходные режимы между механизмами. [1]
Расположение буфера определяет, какая часть электроснабжения получает сглаженную нагрузку. При размещении в стойке внешние участки видят уже обработанный профиль, а внутренние шины постоянного тока и вычислительные узлы продолжают обслуживать быстрые переходы. Требования к их динамической устойчивости сохраняются. [1]
Как совместное управление меняет график
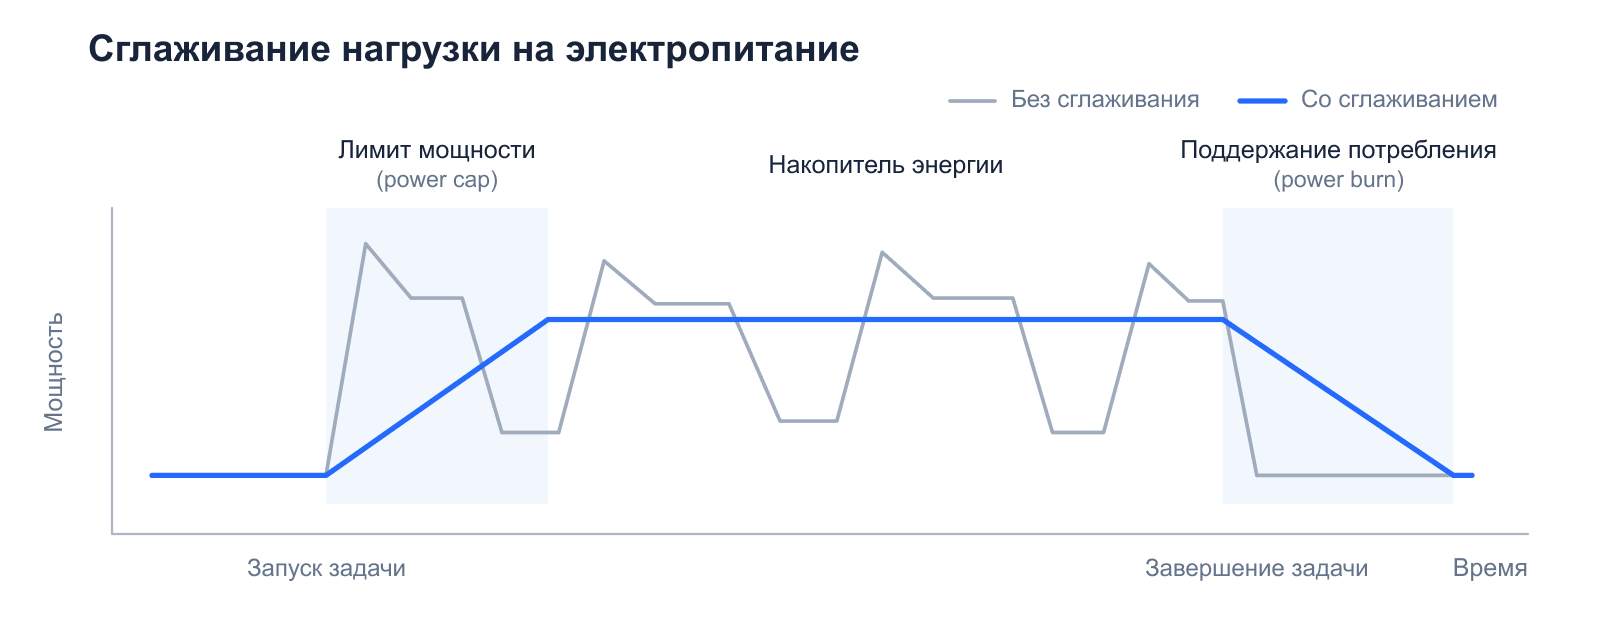
Рисунок 2. Серая линия показывает исходный профиль, синяя показывает результат сглаживания. Слева power cap ограничивает подъем при запуске, в середине накопитель компенсирует быстрые колебания, справа power burn обеспечивает плавный спад.
Практический эффект накопителей был проверен при обучении Megatron LLM на одной и той же стойке GB200. Замена блоков питания прежнего поколения на блоки с накоплением энергии снизила пиковую мощность со стороны электросети на 30%. Колебания на выходе блоков питания при этом сохранялись. Результат характеризует уменьшение входного электрического пика в конкретном испытании; финансовый эффект определяется тем, как этот профиль меняет требования к инфраструктуре площадки. [1]
Вывод
Для современных ЦОД прикладной рабочий цикл программ становится исходным параметром инженерного проекта ЦОД. Возможность усреднить независимые нагрузки уступает место необходимости управлять крупными синхронными потребителями. Экономический смысл сглаживания состоит в том, чтобы обслуживать кратковременные переходы эффективно и рассчитывать внешнюю инфраструктуру по профилю, который действительно до нее доходит.
Для этого сначала измеряют нагрузку на уровнях GPU, стойки и ввода, затем согласуют допустимые переходы для основного и резервного питания и выбирают сочетание управления и накопителей. Его проверяют при запуске, обучении и завершении задач. Результат оценивают по оставшимся пикам и скорости изменения мощности, времени выполнения полезной работы и расходу энергии на задачу. На этой основе рассчитывается необходимый запас: снижение электрических максимумов должно давать технический и экономический эффект с сохранением требуемой надежности.
Источники
-
How New GB300 NVL72 Features Provide Steady Power for AI (NVIDIA Technical Blog).
-
Power Stabilization for AI Training Datacenters (Microsoft, OpenAI, NVIDIA).
-
NVIDIA GB200 NVL Multi-Node Tuning Guide (Power and Thermals).